执行环境工程:如何构建永不崩溃的 AI 工作流
Harness Engineering: How to Build AI Workflows That Never Fall Apart
原文:Harness Engineering: How to Build AI Workflows That Never Fall Apart
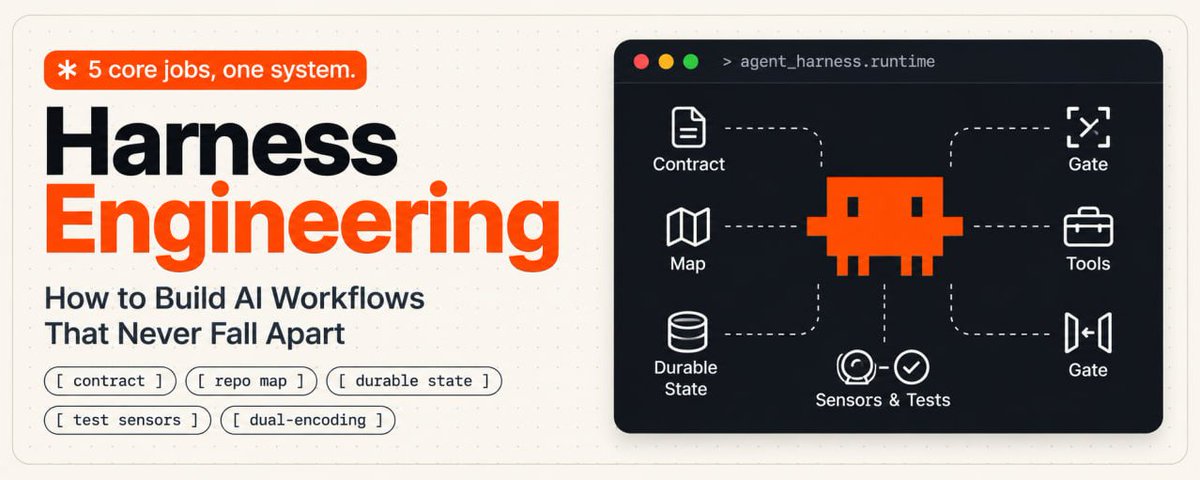
大多数人应对失效的 AI 输出,靠的是重写提示词
然后,他们更换模型
然后,他们升级到更大的上下文窗口
模型仍然会忘记指令
它仍然会推荐错误的工具
它仍然会跳过验证
它仍然会对已经损坏的工作成果宣称成功
问题不在模型权重之内
问题出在执行环境中
那个环境,就是执行环境
设计它,就是执行环境工程
达里奥·阿莫迪在 Claude Code 发布时直接说明了这一点:
"当然,你需要一个界面,你需要一个执行环境来使用它们"
模型扮演的是推理引擎的角色
模型能够预测下一个逻辑步骤
但它无法单凭自身构建一个稳定的操作系统
执行环境控制着模型读取哪些内容、能够触发哪些工具、哪些数据能在上下文重置后留存,以及执行必须在何时停止
提示词工程调整的是措辞
执行环境工程构建的,是让这些措辞得以运行的基础设施
把一个前沿模型放进一个空聊天框,它只会生成泛泛而谈的文字
把同一个模型放进一个配备终端访问权限、自动化测试套件、项目地图和隔离工作区的代码仓库,它就能交付可用的软件
模型权重完全相同
执行环境改变了一切
OpenAI 在用 Codex 训练智能体时,记录到了同样的模式
他们早期的运行之所以失败,是因为环境定义得不够充分
工程团队刻意没有要求模型更加努力
他们构建了明确的能力检查和机制化边界
当某个智能体反复失败时,别再修改系统提示词里的形容词了
去检查模型周围的那个操作系统吧
可靠 AI 系统的三个层级
构建者常常把提示词链、智能体循环和多智能体工作流图当成彼此竞争的理念
它们其实是同一个系统的三个不同层级
1. 执行环境层(环境与记忆)
执行环境由存在于模型权重之外的一切构成
它管理文件系统访问权限、环境变量、认证令牌和持久文件
安德烈·卡帕西确立了那个具有决定意义的心智模型:
模型就是处理器(CPU)
上下文窗口就是内存(RAM)
一个既没有存储也没有操作系统的裸处理器(CPU),会立刻崩溃
当用户把二十页背景材料一股脑塞进同一条提示词时,就等于把内存(RAM)灌满了
模型会丢失对关键规则的注意力
一个整洁的执行环境会把项目知识存放在外部 Markdown 文件中
它只加载当前步骤所需的那一段确切片段
2. 循环层(证据与收敛)
输出代码或文本的模型需要自动化验证
问模型“你确定这是对的吗?”会造成循环往复的幻觉循环
模型评估的是自己的概率预测,并会确认它最初的偏向
循环层引入了客观的检测器:
- 测试运行器(pytest、vitest、cargo test)
- 格式校验器(JSON Schema 检查器、代码检查器)
- 执行预算(最多尝试四次,超出后交由人工审查)
模型提出修正建议
执行环境运行测试并提供原始的终端输出
只有当机制化证据确认修复有效时,执行才会继续
3. 工作流图层(任务分配)
长任务一旦被强行塞进单条无休止的对话线程,就会走向崩溃
工作流图层把工作分散到相互隔离的执行上下文中
一个执行单元分析任务并撰写实现蓝图
第二个执行单元在隔离的目录分支中编写代码
第三个对抗式执行单元对照项目需求审查代码 diff
上下文始终保持干净
没有任何单个提示词需要独自背负整个项目生命周期的重担
个人 AI 执行环境的 5 项核心工作
应用执行环境工程并不需要庞大的企业级平台
个人执行环境只需要在你的日常工作流中落实五条机制化规则
1. 把每一个请求变成一份边界契约
对话式提示词会让模型悄悄重新定义什么叫成功
当模糊的提示词遇到阻力时,模型会转而去解决一个更简单的邻近任务,然后报告胜利
一份生产级契约会在生成开始之前就设定硬性边界:
- 交付物:确切的文件名与格式
- 约束:允许使用的依赖、风格要求、Token 预算
- 非目标:明确列出模型不得触碰的事项
- 验收标准:关闭任务所需的确切条件
没有明确的契约,就由模型自己决定何时算完成
有了契约,则由验收标准来决定模型何时算完成
2. 提供一张地图,而不是一部百科全书
时间跨度一长,上下文衰减就会冲击每一个前沿模型
把整份项目文档文件一股脑倒进对话,既消耗 Token,又稀释专注力
顶尖的构建者会制作一张紧凑的项目地图
这张地图勾勒出文档、模式文件和源文件的存放位置
模型扫描项目地图,选中唯一相关的文件,并且只读取它一个
紧凑的项目地图保留工作记忆
巨大的提示词堆砌则会把它耗尽
3. 把记忆外部化为持久文件
聊天记录只充当临时的草稿空间
对话线程不是数据库
会话一旦拖长,注意力就会衰减,上下文窗口也会被填满
把架构决策、用户偏好和尚未解决的缺陷存进专门的项目文件
在 Claude Code 和 Cursor 中,这个文件就是 CLAUDE.md 或 .cursorrules
开启新会话时,模型读取该文件,立即就能接续工作
工作成果能扛过聊天记录清除、速率限制和模型切换
4. 先搭建检测器,再授予自主权
智能体无法修复自己观察不到的错误
对模型说“写出没有缺陷的代码”不会带来任何改变
提供一条能输出退出码零或堆栈跟踪的命令,模型才有了事实基准
检测器把主观质量转化为可验证的证据:
- 遇到语法错误就会报错的编译器和类型检查器
- 验证数据转换的自动化测试脚本
- 确认所有必填字段都已存在的清单校验器
模型创建产物
检测器生成证据
执行环境判定这次运行是否通过
5. 应用双重编码规则
用平实的语言写规则,会给概率性失效留下空间
模型读到这条指令,又解析了另外二十条约束,负载一高就会跳过这条规则
双重编码能一劳永逸地解决这个问题:
首先,用文字解释这条规则,让模型理解目标
其次,设置一道机制化闸门,一旦规则被打破就阻断执行
如果智能体必须避免删除文件,就在提示词里告诉它
然后限制它的终端权限,让 rm -rf 抛出操作系统错误
提示词引导意图
机制化闸门保护系统
如何搭建个人微型执行环境
下面就是一个五分钟就能搭好的执行环境结构,可以粘贴到任意代码仓库、Claude Project 或 Cursor 工作区
把以下内容以 HARNESS.md 为文件名保存到项目根目录:
# Project Operating Contract

## Operating Boundaries
- Allowed scope: Modify only files explicitly assigned in the current task
- Forbidden actions: Never delete existing tests, never add unverified dependencies

## Project Map
- /src: Application source code
- /tests: Validation test suites
- /docs/decisions.md: Durable log of accepted architectural choices

## Verification Protocol
Before marking any task complete, run these checks in order:
1. Run local linter: `npm run lint`
2. Run test suite: `npm test`
3. Verify output format matches the requested schema

## Failure Escalation
If a test fails twice on the same error:
- Stop autonomous editing
- Print the exact error log
- State the proposed fix and wait for user confirmation
这个简短的文件取代了每次对话中二十行重复的提示
它确立项目范围、控制文件访问,并强制执行机制化验证
两遍式提示流程工作流
在标准聊天界面中处理高难度的推理任务时,使用两遍式执行环境循环
大多数用户只想要一个答案,然后接受第一稿
生产工作流把生成与评审拆分成两个独立的遍次
第一遍:执行阶段
Draft the technical specification for [Feature X].
Follow the constraints listed in HARNESS.md.
Do not evaluate your own output yet.
Output the raw draft and state all assumptions made.
第二遍:对抗式审查阶段
Review the draft above as a skeptical senior reviewer.
Check against these specific failure points:
1. Are edge cases handled when input arrays are empty?
2. Does the logic introduce extra dependencies?
3. Does the solution violate any constraint from HARNESS.md?

List every failure point found.
Then output the revised version fixing those gaps.
将创作者角色与审查者角色分离,能让幻觉式表述减少一半
当模型被明确要求攻击自己的错误时,它就无法再为这些错误辩护
为什么执行环境会持续复利
模型每隔几个月就会更新
今天还奏效的提示词,换到下一个模型检查点上往往就会产生不同的输出
执行环境工程能保留你的工程投入
当 Anthropic 发布更新版 Claude,或 OpenAI 推出新的推理模型时,你的提示词可能只需微调
你的测试套件、项目地图、权限边界和持久状态文件都完好无损
它们马上就能在新模型上正常工作
模型提供的是原始认知算力
执行环境提供的则是轨道,把算力转化为可靠的执行
别再反复调整提示词里的形容词
开始围绕它们构建执行环境